
代码评审中经常会遇到这种情况:打开文件后,所有函数都不超过五行。
这是上一篇文章 代码异味 #2 的后续内容。
命名也很合适,每个类只有一个职责。没有什么可挑剔的。
然而,当有人问“点击这个按钮后会发生什么?”时,没人能立即回答。
这类代码称为 Ravioli Code(C2 原文)。
不只是贬义
有趣的是,这个词并不总是用于贬义。Ravioli 是由一小块一小块面皮包住馅料的意大利面。
它代表封装良好的小对象,也就是面向对象所追求的形态。实际上,也有人把 Ravioli 视为 Spaghetti 代码的反面。
问题在于数量。
每一块都很完美,但盘子里有 200 块,没人记录它们按什么顺序、以什么方式连接。
具体来说,就是这种样子。
final class CheckoutCoordinator {
    func start() { validator.validate(cart) }
}

final class CartValidator {
    func validate(_ cart: Cart) { stockChecker.check(cart.items) }
}

final class StockChecker {
    func check(_ items: [Item]) { priceCalculator.calculate(items) }
}

final class PriceCalculator {
    func calculate(_ items: [Item]) { paymentPreparer.prepare(items) }
}
// ... 还有 16 个这样的类
每个类都无可挑剔。命名准确,职责也只有一个。
但没有任何文件了解完整的支付流程。
流程只存在于类之间的调用关系中,必须连接调试器才能知道,而不是读代码就能看出来。
为什么会拆得过细
把“函数越短越好”当成规则时。《Clean Code》甚至说函数应该只有两三行,最长也只能四行。
这条建议真正针对的是让一个函数只处理一个抽象层级。但当它被换算成行数,目的就消失了。
结果是 30 个五行函数,其中 28 个只在一个地方被调用。
名称无法概括内容时。、handleUserAction、processData、updateState这类名称无法说明它们做了什么。
拆成这种命名的函数后,读者最终还是要打开函数体,而且拆得越多,需要查看的地方就越多。
好的提取应该让人无需查看函数体,结果却适得其反。
**抽象层级混杂时。**同一个函数里,同时出现“验证订单”这样的策略层语句和“将索引加 1”这样的细节层语句。读者的视线会不断上下移动。
在这种状态下盲目拆分,只会产生抽象层级混乱的碎片。
**为了复用而抽出只使用一次的代码时。**这和制作 Lasagna 代码是同一种心理,只是方向从纵向变成了横向。
成本会体现在跳转次数上
Ravioli 代码的成本可以概括为一句话:为了回答一个问题,要打开几次文件?
阅读代码时,人会把流程暂存在短期记忆中。超过三四个步骤后,这段记忆就会变模糊。
在文件之间跳转六次后,你会忘记最初要找什么,只能重新回到起点。
反复发生后,直接运行确认反而比阅读代码更快。
副作用也会随之出现。
- 添加新功能时找不到已有碎片,于是再创建一个类似的。重复代码悄悄增加。
- 找不到修复 Bug 的位置,于是在流程末端,也就是界面一侧,添加临时处理。
- 完整流程没有写在代码中,只存在于文档或某个人的脑海里。那个人离开团队后,流程也会随之消失。
找回流程的方法
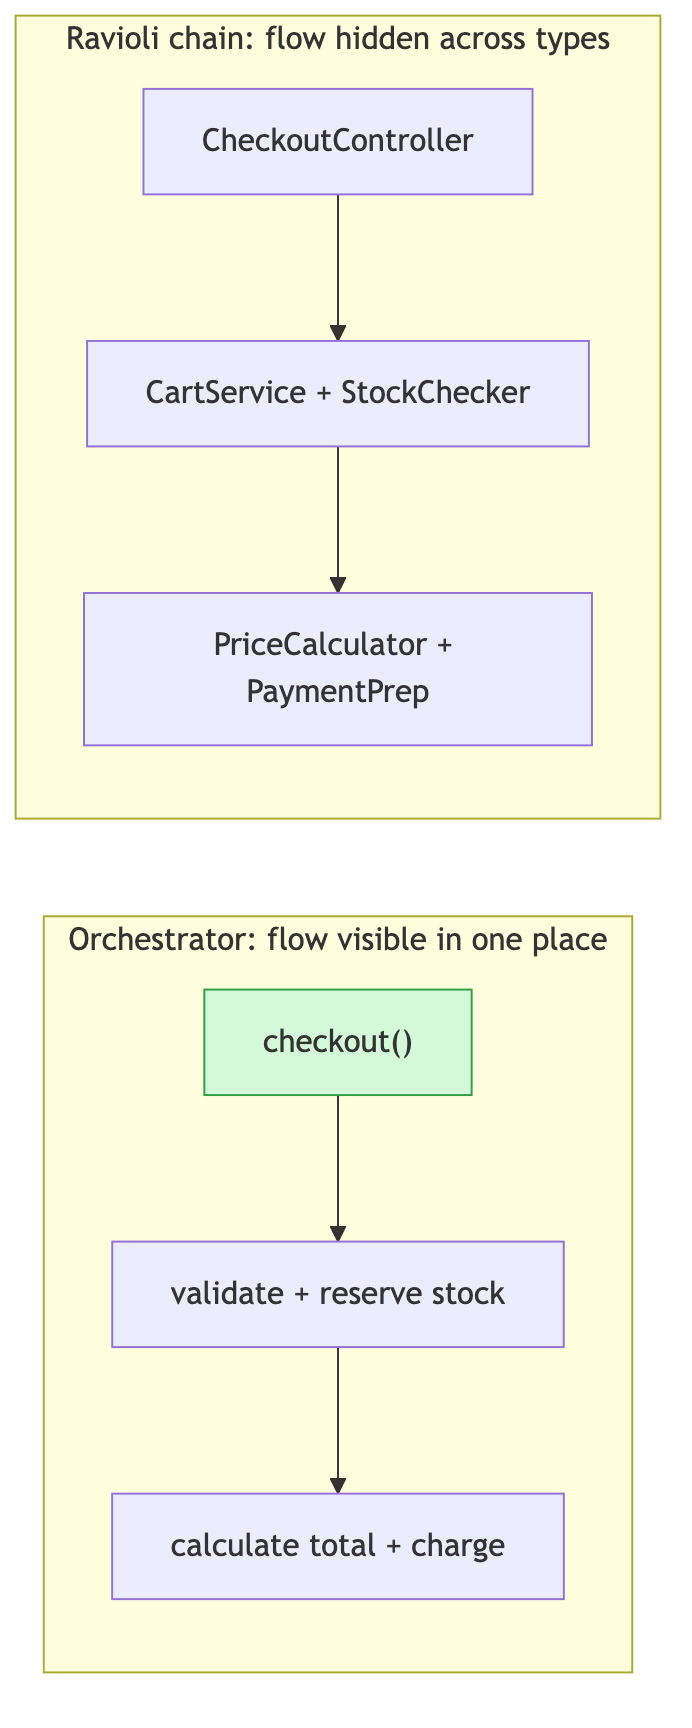
**创建一个记录流程的位置。**这是最有效的措施。
放置一个能一眼展示完整顺序的函数,让它只描述顺序。
func checkout(_ cart: Cart) async throws -> Receipt {
    try validate(cart)
    try await reserveStock(cart.items)
    let amount = calculateTotal(cart)
    let payment = try await charge(amount)
    return try await confirm(cart, payment)
}
细节仍然留在各自的位置。改变之处在于,流程被写在同一个屏幕上。
这类函数也称为编排器。Ravioli 代码缺少的正是这个位置。
**每一层只保留一个抽象层级。**上层函数的五行都是同一高度的语句。如果混入items.count > 0这样的细节条件,层级就被破坏了。
阅读一个函数时,养成检查语句是否处于同一层级的习惯,比遵守拆分标准更有用。
**是否提取由名称决定。**标准不是行数,而是这个问题:“给这个碎片取的名字,是否比函数体表达得更多?”
将if user.age >= 19提取为isAdult(user)能体现意图,因此有价值。将array.append(item)提取为addItem则毫无收获。
**相近的东西放在一起。**一起变化的代码放在同一个文件、同一个文件夹中。
如果为了遵守一个文件一个类型的惯例,反而把总是一起打开的类型分散开,那么邻近性比惯例更重要。
**服务单元也适用同样的标准。**微服务拆分得过细的状态称为纳米服务。
处理一个请求却要经过 12 个服务,这就是 Ravioli 代码扩展到网络另一端的形态。此时,跳转成本还会叠加延迟和故障点。
Lasagna、Ravioli 和 Spaghetti
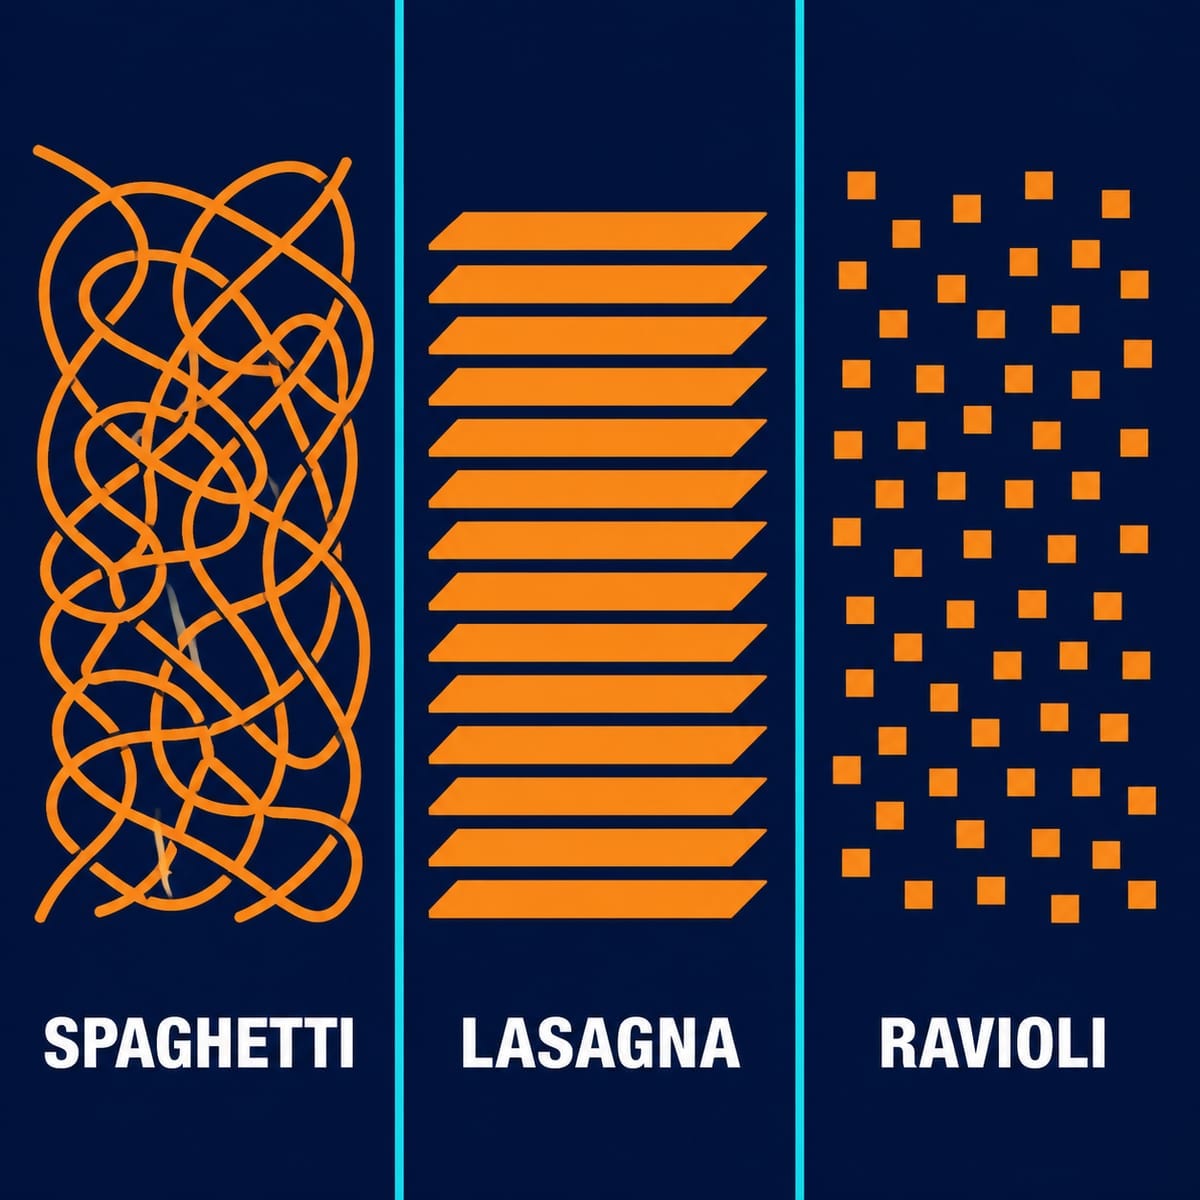
把三者放在一起,可以整理如下。
| 形态 | 碎片状态 | 问题 |
|---|---|---|
| Spaghetti | 庞大且纠缠 | 无法预测执行流程 |
| Lasagna | 纵向分层 | 一次修改需要贯穿多个层级 |
| Ravioli | 细小且整洁 | 碎片之间的流程无处可寻 |
三者的整体理解成本都很高,只是方式不同。
如果只按每个碎片的美观程度衡量代码质量,就发现不了 Lasagna 和 Ravioli。因为它们在碎片层面都无可挑剔。
总结
- Ravioli 代码是小而整洁的碎片过多,导致没人能解释完整流程的代码。
- 它也曾被用于正面指代封装良好的代码。问题在于数量。
- 主要原因是行数规则、含义模糊的名称,以及混杂的抽象层级。
- 解决方案的核心,是提供一个记录流程的位置。
- 提取标准不是长度,而是名称。只有当名称表达得比函数体更多时才提取。
下一篇将讨论完全相反的极端:不是碎片太多,而是只有一个。
我们来看看一个类就了解整个应用的上帝对象。
来源与确认标准
- Ravioli Code — C2 Wiki · 作者原文 · 确认日期 2026-08-17 · 依据:小型封装对象被过度拆分成 Ravioli 代码的比喻