
上一篇中的意大利面代码,是流程彼此纠缠的代码。那么,把流程彻底整理好,就会变成好代码吗?
本文接续上一篇文章 代码异味 #1。
不一定。
你把层次整齐分开,规定每层只能调用下一层,并用接口划出边界,但代码仍会变得让人不想碰。
仅仅为了在界面显示一个字符串字段,就要修改七个文件的代码。这称为千层面代码(Lasagna Code)(C2 原文)。
层层整齐堆叠的代码
正如名字所示。千层面是把面皮和酱汁一层层堆叠起来制作的。
剖面整齐,层次分明。问题是,你无法只取出其中一层。
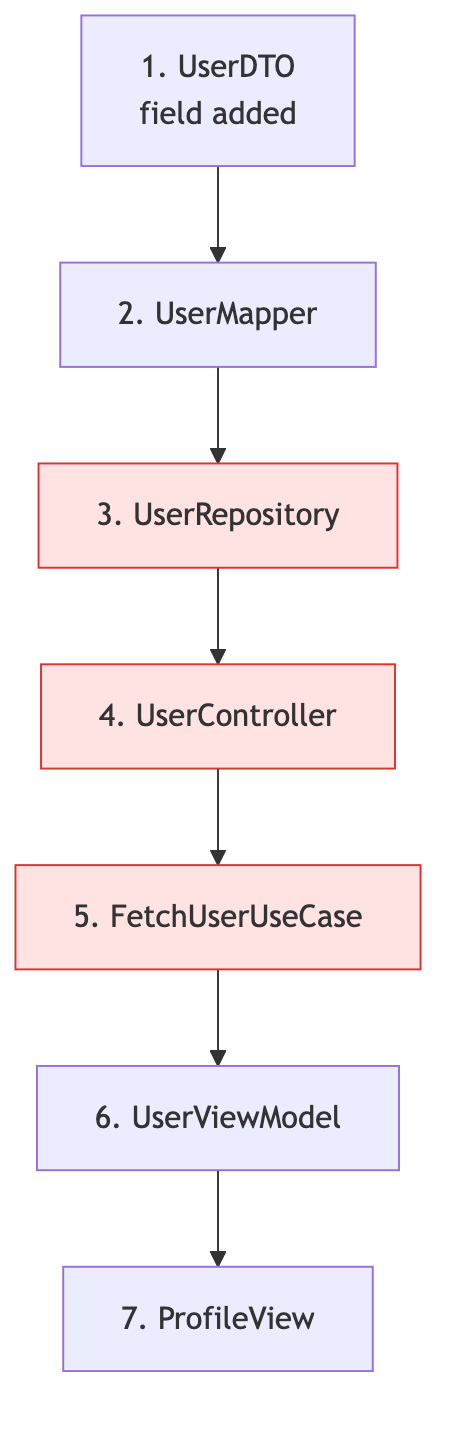
来看一个典型例子。服务器返回的用户信息新增了nickname字段,只需把它显示在界面上。
1. UserDTO            — 在服务器响应结构体中添加字段
2. UserMapper         — DTO在转换为领域模型的代码中添加一行
3. User               — 在领域模型中添加属性
4. UserRepository     — 协议签名改变时,这里也要修改
5. FetchUserUseCase   — 只是传递,但类型导致必须修改
6. UserViewModel      — 再次转换为界面模型
7. ProfileView        — 终于显示出来
从 DTO(Data Transfer Object,数据传输对象)到界面,同一个字符串会被放进三种不同类型中。
七个文件中,真正做决策的地方有几个?通常只有一两个。
其余代码只是原样把值传下去。
这种层称为传递层(pass-through layer)。
在架构模式文献中,请求不做任何处理、只穿过各层的状态,也称为沉洞反模式。这正是千层面代码的核心症状。
为什么会这样
没有人是出于恶意才这样做的。事实上,通常恰恰相反。
层数增加,大多是因为脱离上下文地应用了好建议。
**把“分离层次”当成规则时。**看到 Clean Architecture 图,就按圆圈数量创建文件夹。
那张图并没有规定应该有多少层,而是描绘了依赖只能向内的原则(Presentation-Domain-Data Layering)。
但当它被转换为文件夹结构时,含义就变了。
**把“依赖抽象而不是实现”应用到所有地方时。**就会产生大量只有一个实现的协议。
UserRepository一个协议和UserRepositoryImpl一个实现。这个协议唯一的作用,就是再增加一次代码跳转。
如果目的是在测试中插入伪实现,这有价值;但如果没有这样的计划,就只是增加了一层。
**提前为“以后可以更换”做准备时。**因为数据库可能变化而抽象,因为服务器可能变化而再包一层。
YAGNI(You Aren’t Gonna Need It)警告的正是这种情况。
**团队壮大后按层次拆分时。**正如康威定律所说,组织的沟通结构会原样刻进架构。
团队有四个,层次也很容易变成四个,而且边界往往遵循人的边界,而不是技术需求。
成本从哪里产生
层次太多究竟有什么问题?下面具体说明。
**修改成本与层数成正比。**一个字段就要改七个文件。更可怕的是,开发者会试图避开它。
不按规范逐层传递,而是在 ViewModel 中直接调用 API 的捷径就会出现。
如果规则难以遵守,就会出现绕过规则的代码。最终层次还在,流程却变成了意大利面。千层面生出了意大利面。
**阅读成本很高。**要知道某个值从哪里来,必须沿着层次往下追。
每层都短小清晰,但跳转七次后,你会忘记最初的问题是什么。
**调试会变慢。**堆栈跟踪变长,要找到值在哪一层出错,就必须在每层设置断点。
**构建会变慢。**如果把层次拆成模块,尤其如此。每次修改下层,所有上层都会重新构建。
什么时候需要层次,什么时候不需要
这并不意味着要消除层次,而是需要判断标准。
有一个问题通常很有效。
“这一层是在做决策,还是只负责传递?”
做决策意味着进行转换、验证、分支或组合。把服务器日期字符串转换为Date的映射器就在做决策。
有缓存就用缓存、没有就用网络的仓储也在做决策。相反,原样接收并传递参数的 UseCase 什么都没有决定。
另一个标准是修改原因。服务器响应格式改变,与界面显示规则改变,原因并不相同。
因此,DTO 与界面模型值得分开。反过来,如果领域模型和界面模型总是一起变化,就没有分开的理由。
整理成表格如下。
| 情况 | 是否应该设置层次 |
|---|---|
| 外部响应格式与内部模型独立变化 | 应该 |
| 确实有替换实现的计划 | 应该 |
| 测试中需要伪实现 | 应该 |
| 规模较大,需要把团队边界刻进代码 | 有条件地应该 |
| 只有一个实现,未来也只有一个 | 不应该 |
| 只接收值并原样传递 | 不应该 |
| 因为图中有这一层,所以创建了它 | 不应该 |
如何移除层次
处理已经堆好的千层面,大致可以按以下顺序进行。
**先找传递层。**如果方法体只有一行,而且这一行调用了另一个对象的同名方法,就是候选。
在整个项目中搜索这种模式,很快就能得到列表。
**统计实现数量。**查看每个协议有几个实现。如果只有一个,测试中也没有使用,就删除协议,直接使用具体类型。
这时最好不要以性能为理由。any UserRepository通过同一个存在类型调用,确实会经过 witness table。
但如果把协议用作泛型约束,经过特化后这项成本会消失。相反,不是final的类,即使用具体类型调用,默认仍是动态派发。
而且,在跨越网络或数据库的仓储调用中,这个差异不会体现在实际测量中。
删除协议的原因不是性能,而是跳转次数。
**合并类型。**如果 DTO 和领域模型字段相同,并且总是一起变化,就使用一个类型。
也有人认为把Codable直接附加到领域模型是污染。但应先判断这种污染何时会成为问题。
**合并到同一层。**如果删除层次让人有压力,可以保留层次但合并文件。
仅仅把协议和实现放在同一个文件中,就能减少跳转次数。
总结
- 千层面代码是层次过多,导致即使很小的修改也要修改多个文件的代码。
- 通常不是因为写了糟糕的代码,而是因为脱离上下文地应用了好建议。
- 核心症状是传递层:什么都不决定,只把值传到旁边的层。
- 判断标准有两个:这一层是否做决策,以及它是否因不同于其他层的原因而变化。
- 规则难以遵守时,就会出现绕路。层次过多,最后意大利面也会一起长出来。
下一篇讨论的,是问题不在层次而在碎片的情况。我们将介绍拉维奥里代码:每个类都很小、封装良好,但没人能解释整体流程。
来源与确认标准
- Lasagna Code — C2 Wiki · 作者原文 · 确认 2026-08-17 · 依据:千层面代码的隐喻与过度分层问题
- Presentation-Domain-Data Layering — Martin Fowler · 作者原文 · 确认 2026-08-17 · 依据:分层的目的与修改边界