

Na Parte 3, vimos como limpar o histórico da conversa com /clear. Porém, ao verificar o contexto restante logo depois, ele não aparece como 100%. Execute /context no Claude Code e o motivo fica claro. O prompt do sistema, as definições de ferramentas, o CLAUDE.md e as ferramentas registradas pelos servidores MCP já consomem dezenas de milhares de tokens. Antes mesmo de a conversa começar.
Esta parte trata do “contexto carregado permanentemente”. Se o histórico da conversa é um custo variável, este é um custo fixo. Ele é enviado em todos os turnos, não desaparece com /clear e ocupa parte da atenção do modelo durante toda a sessão. Um projeto ruim desse custo fixo faz qualquer sessão começar em desvantagem, então ele deve ser corrigido antes do gerenciamento da conversa.
O que já está carregado antes do início da sessão
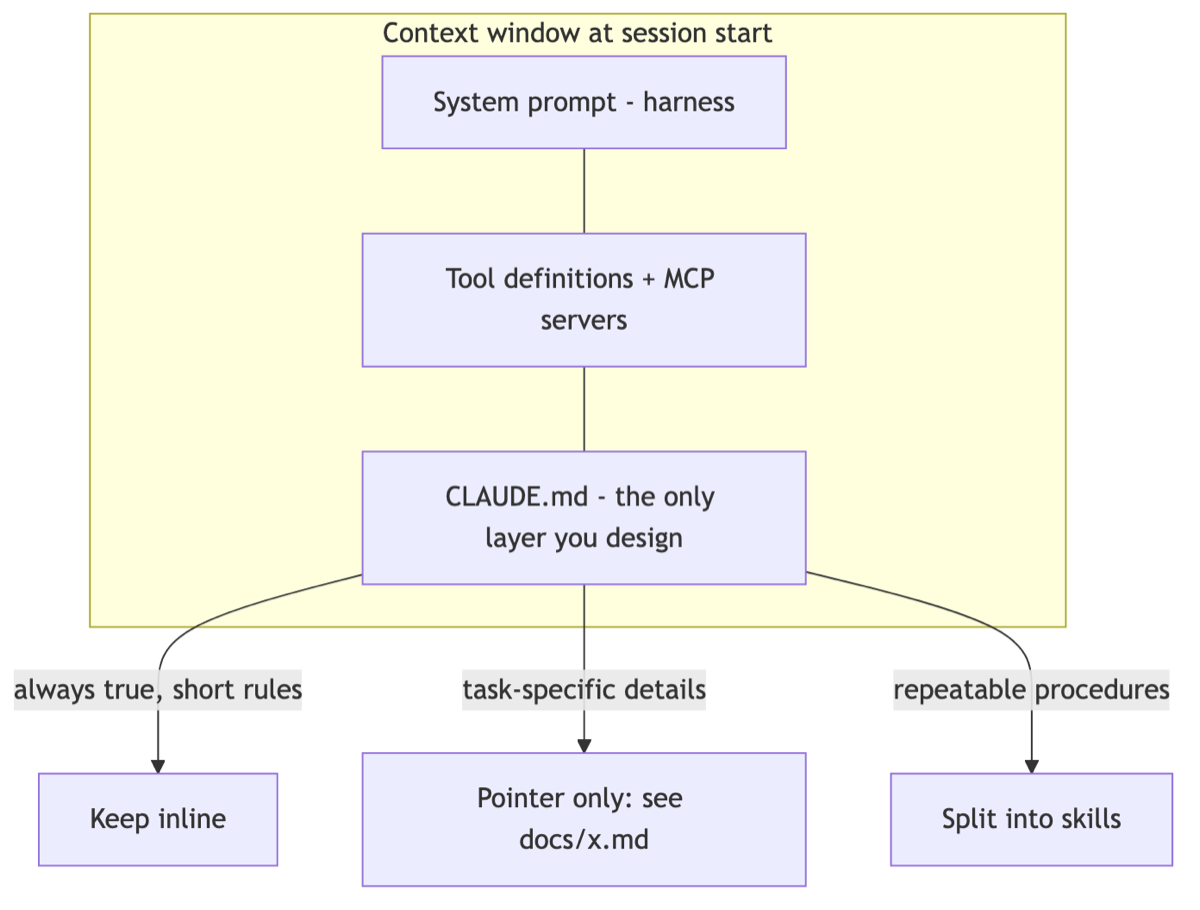
A janela de contexto de um agente não começa como uma página em branco. Várias camadas já estão instaladas antes da chegada da primeira entrada do usuário.
Na base está o prompt do sistema. Ele contém as instruções básicas instaladas pelo harness do agente—um ambiente de execução como o Claude Code—, incluindo regras de uso de ferramentas e formato de resposta, somando milhares de tokens. O usuário não pode alterar essa área.
Acima dele vêm as definições de ferramentas. Para usar uma ferramenta, o modelo precisa conhecer seu nome, descrição e esquema de parâmetros, e tudo isso entra no contexto como texto. Com apenas as ferramentas padrão, o custo não é alto, mas a situação muda quando você conecta servidores MCP. É comum um servidor registrar dezenas de ferramentas, e apenas alguns servidores podem consumir dezenas de milhares de tokens só com definições. Ferramentas que você nunca usa fazem a viagem de ida e volta em todos os turnos.
A última camada são arquivos de instruções do projeto, como o CLAUDE.md. Configurações globais, do projeto e de subdiretórios são carregadas automaticamente, e esta é a única camada que o usuário pode projetar diretamente.
Princípio do CLAUDE.md: mantenha apenas o que é sempre verdade
Há um único critério para decidir o que colocar no CLAUDE.md: “Isso é sempre verdade para todas as tarefas deste projeto?” Como o arquivo é enviado em todos os turnos e tarefas, conteúdo relevante para algumas tarefas, mas irrelevante para outras, não merece ocupar espaço.
Comandos de build e teste, a estrutura geral da base de código e poucas regras que não podem ser violadas passam no critério. Já especificações detalhadas de um recurso específico, a documentação completa de uma biblioteca e registros de trabalhos anteriores só são necessários em tarefas específicas, então ficam de fora.
Existe um paradoxo sobre o tamanho. Pode parecer que escrever mais instruções melhora a obediência, mas na prática ocorre quase o contrário. Como vimos na Parte 2, um contexto mais longo dilui a atenção dada a cada item e, em um arquivo de instruções com centenas de linhas, as regras importantes ficam perdidas no lost in the middle. Com 50 regras, todas as 50 são seguidas de modo vago; com 10, essas 10 são seguidas com clareza. Se o agente continua violando as regras do CLAUDE.md, talvez a ordem certa seja reduzir o arquivo antes de adicionar regras.
Não carregue tudo; carregue apenas ponteiros
Então, onde colocar os documentos detalhados que não passaram no critério, ou seja, os necessários apenas ocasionalmente? A resposta é: “mantenha-os fora do contexto e informe apenas a localização”.
Em vez de incluir todo o procedimento de migração do banco de dados no CLAUDE.md, escreva uma linha: “Consulte docs/migration.md para o procedimento de migração”. O agente lê esse arquivo apenas ao realizar uma migração. O conteúdo detalhado entra no contexto somente nas sessões que precisam dele; as demais pagam apenas o custo de um ponteiro de uma linha.
O skill do Claude Code sistematiza o mesmo princípio. Um skill é um procedimento para uma tarefa específica; normalmente, apenas seu nome e uma descrição de uma linha ficam no contexto, e o corpo é carregado quando a tarefa começa. Se você transformar o “procedimento de deploy” em um skill em vez de mantê-lo residente no CLAUDE.md, economizará esses tokens nos 99% dos turnos que não envolvem deploy.
As ferramentas também precisam ser podadas. Se houver um servidor MCP conectado, mas sem uso, desativá-lo elimina dezenas de milhares de tokens de custo fixo. Cada vez mais harnesses oferecem carregamento tardio, mantendo normalmente apenas os nomes das ferramentas e carregando os esquemas completos quando necessário. A direção é a mesma: carregar o necessário quando necessário, em vez de carregar tudo o tempo todo.
Rotina de revisão do custo fixo
O contexto carregado permanentemente é difícil de perceber depois que cresce. O custo é igual em todas as sessões, então não há referência para comparação. Por isso, vale a pena revisá-lo conscientemente de tempos em tempos.
No Claude Code, /context detalha onde e quanto do contexto atual está sendo usado. Ele mostra tokens do prompt do sistema, das ferramentas, do MCP e dos arquivos de memória; se as definições de ferramentas parecerem anormalmente maiores que a conversa, comece podando os servidores MCP. Abra o CLAUDE.md aproximadamente uma vez por trimestre e remova linhas com base no critério “esta linha realmente ajudou no mês passado?”. Arquivos de instruções só crescem quando são abandonados, então a poda precisa virar rotina para mantê-los curtos.
Resumo
- O prompt do sistema, as definições de ferramentas e o CLAUDE.md são custos fixos enviados em todos os turnos. Eles não desaparecem com /clear, portanto precisam ser projetados antes do gerenciamento da conversa.
- O critério para o CLAUDE.md é “Isso é sempre verdade para todas as tarefas?” Como o tamanho deixa cada regra menos nítida, quando as regras não são seguidas, a primeira medida é reduzir o arquivo.
- Use ponteiros em vez de documentos detalhados completos, separe procedimentos recorrentes em skills e desative servidores MCP que não são usados. O princípio é carregar o necessário somente quando necessário.
Com isso, o contexto de uma sessão fica bastante limpo. Mas, por mais que você economize, chega um momento em que uma tarefa grande não cabe em uma única sessão. A próxima parte apresenta a solução estruturada para esse caso: subagentes. Veremos como um padrão de isolamento—pedir a exploração a outro contexto e receber apenas a conclusão—preserva o contexto.
Leitura recomendada
- Regras e memória do Claude Code: qual é a diferença entre o CLAUDE.md e o recurso de memória?
- [MCP·Skill #2] Guia completo de Skills para agentes de IA, dos comandos de barra aos gatilhos automáticos
- [Contexto de IA #5] Por que usar subagentes? Princípios do isolamento de contexto de agentes de IA e critérios de delegação